长时程 Agent 的校准:推理时的置信度与不确定性
目录
- 10.5 更新 Reflection Beam
- 为什么长时程 Agent 需要经过校准的不确定性
- 问题设定与 Agent 不确定性的形式化表达
- 测量和校准轨迹不确定性
- 依据不确定性采取行动
- 利用不确定性实现自我改进与自我演化
- 如何评估 Agent 的校准
- 开放问题
- 总结
- 如何引用
- 参考文献
对于语言模型的一次回答,“置信度”似乎只是一个数字:这个输出有多大概率是正确的?我们可以估计它,用温度缩放等方法校准,然后针对这一次回答做判断。
对于长时程 Agent,置信度不只是一个需要报告的数字,而是一个需要据此采取行动的控制变量。Agent 在每一步都要面对与下一个 token 不同层面的可靠性决策:现在应该执行这个动作,向用户提问,调用验证器,进行反思,停止,交给人类,还是把这次失败记录下来,留作以后学习的经验? 这些决策在几十步中不断累积,其质量决定了一个系统只是能演示,还是能够真正部署。
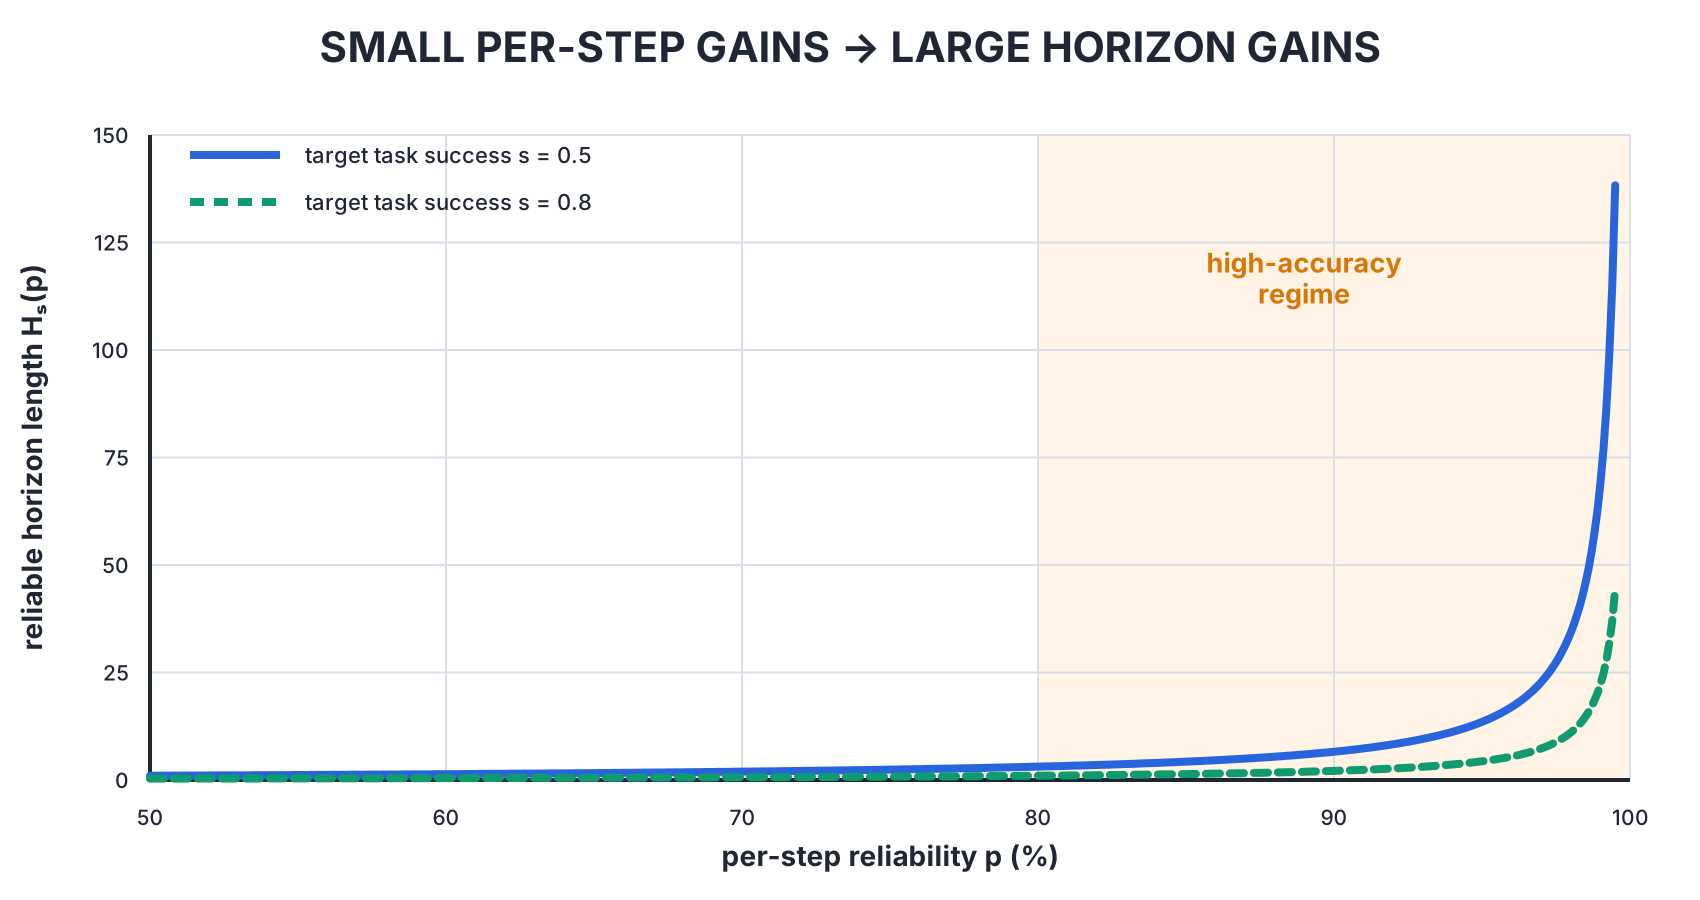
这种变化很容易被低估,因为 Agent 看起来仍然是一个输出文本的模型。但它的失败模式已经不同。早期错误不会只影响局部:一旦写入轨迹,它就会成为后续每一步推理的上下文。在每一步独立成功、且无法纠错的简化假设下,单步可靠性为 90% 的过程重复二十次,整体成功率只有约 12%。而当 Agent 已经悄悄偏离正确方向时,它仍然可能非常自信,因为在那个错误的“世界”里,局部推理看起来依旧流畅。
因此,单轮问题——最终回答是否经过校准?——不足以描述 Agent。Agent 的可靠性是一种轨迹级、会传播、并且需要能够指导行动的属性。
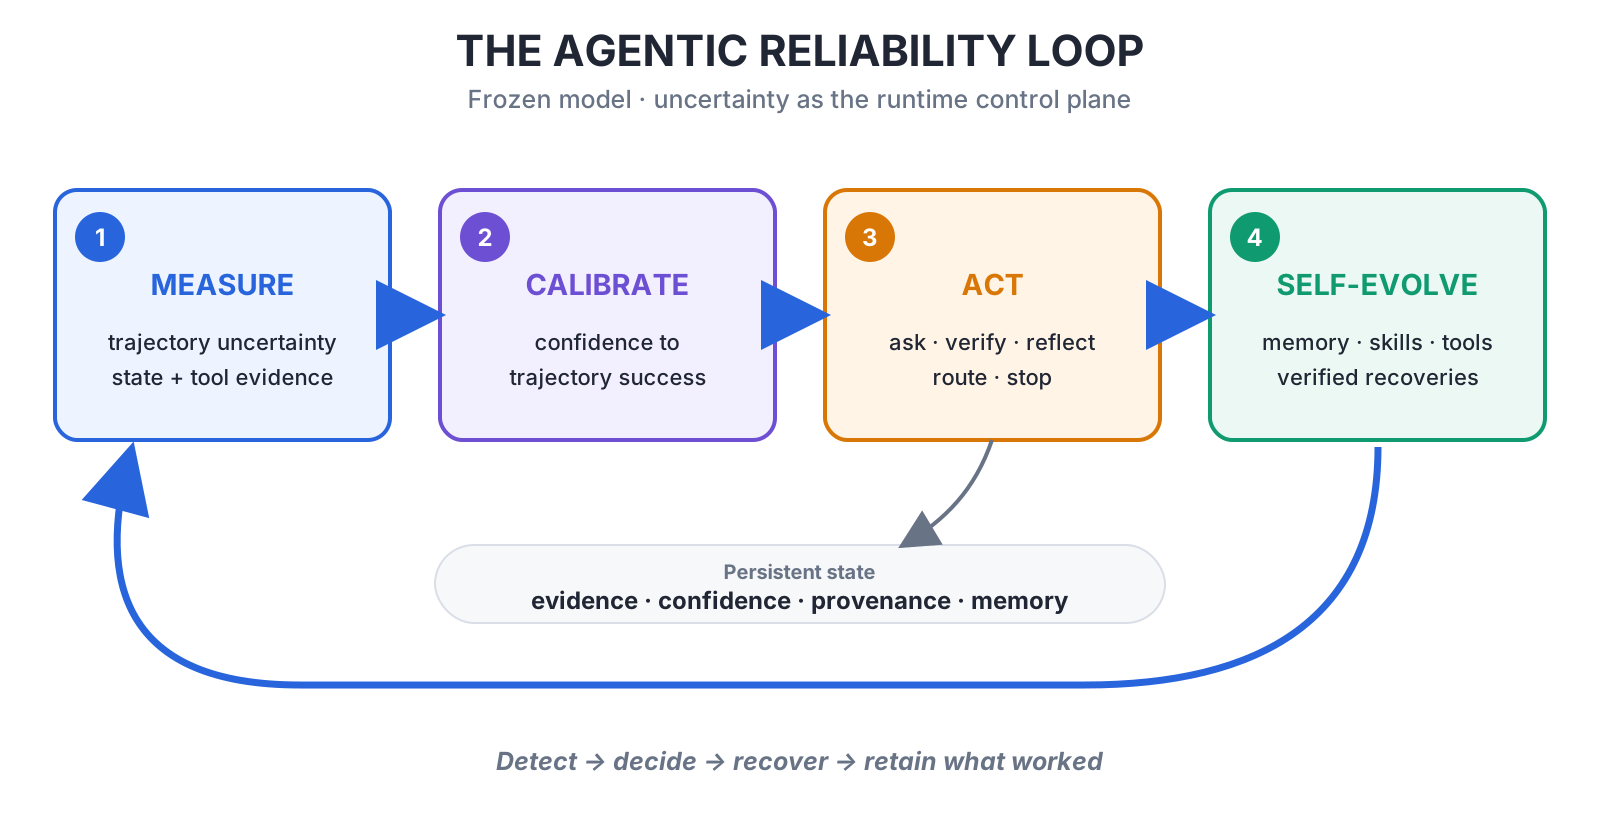
本文讨论的是推理时(inference-time)的视角:基础模型的权重保持冻结,我们不更新参数,而是在模型周围构建可靠性机制——测量轨迹不确定性,校准它,依据它采取行动,再把结果反馈到 Agent 的记忆与技能中。配套的 post-training 视角则讨论,如何把经过校准的置信度进一步内化到模型权重中。
本文论点。 在模型冻结的条件下,不确定性可以成为可靠、且能够持续改进的长时程 Agent 的控制层:沿轨迹测量它,校准它,依据它行动,再让它驱动系统的自我演化。
贯穿全文的三个例子。 为了把抽象概念落到具体场景,本文始终使用以下三个例子:
- E1——深度研究,类似 GAIA 或企业深度研究。 Agent 需要经过搜索、阅读和综合,回答一个开放式研究问题并生成报告。状态:外部证据,例如网页和文档。验证器:报告质量标准或参考答案;通常不能像单元测试那样直接验证。
- E2——零售工具 Agent,类似 τ²-bench。 客户希望退货,Agent 需要遵循书面政策,调用订单数据库上的类型化工具,并与模拟用户交互。状态:SQL 数据库。验证器:数据库最终状态,以及政策与沟通检查;相对可验证。
- E3——编码或软件工程 Agent,类似 SWE-bench。 Agent 在代码仓库中定位 bug、修改文件并运行测试。状态:代码仓库与文件系统。验证器:从失败变为通过的测试;可以验证,但只能覆盖实际存在的测试。
为什么长时程 Agent 需要经过校准的不确定性
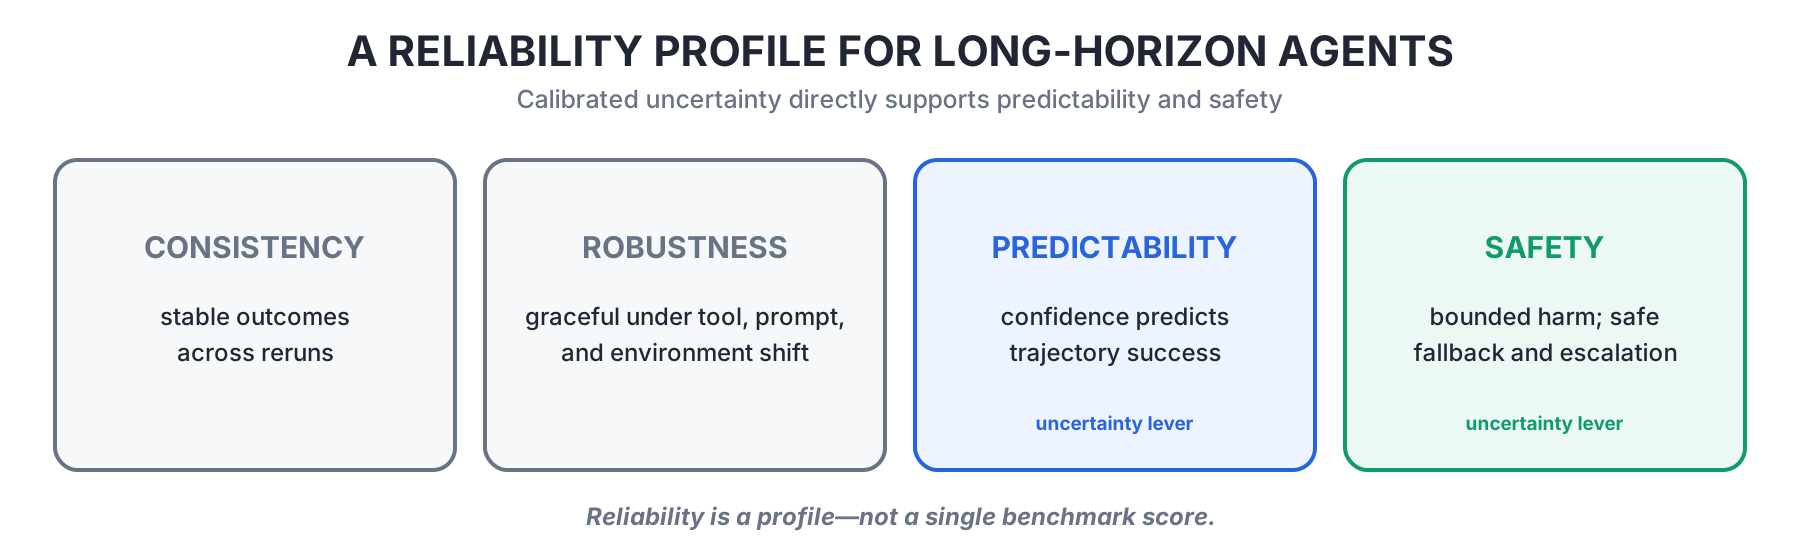
Benchmark accuracy 不等于 Agent reliability。Benchmark 往往只问一个问题:最终答案是否与标签相符?部署中的 Agent 还需要回答更困难的问题:多次运行是否一致?工具失败或证据过期时,能否平稳降级?能否发现任务描述不完整?能否在不可逆操作前暂停?能否在轨迹执行途中发出警告,而不是再浪费四十次工具调用?它的置信度预测的是整条轨迹成功,还是只是文本读起来流畅?
换言之,可靠性更适合被描述为一组特征画像,而不是一个标量。一个实用的画像包括四部分:一致性、鲁棒性、可预测性和安全性(Rabanser et al., 2026)。置信度与不确定性最直接服务于后两者:系统能否预测自己的失败,以及把高风险情况路由到安全的后备行为?
错误会随着执行时程累积
从最简单的模型开始。假设每一步以概率 \(p\) 独立成功,任务要求连续 \(T\) 步全部正确,而且没有自我纠错机制,那么:
\[P(\text{task success}) \approx p^{T}.\]在目标成功率为 \(s\) 时,Agent 能维持的执行时程近似为:
\[H_s(p) \;\approx\; \frac{\ln s}{\ln p}.\]这也是 The Illusion of Diminishing Returns 的核心观察(Sinha et al., 2025):当 \(p \to 1\) 时,\(H_s\) 呈双曲式增长。因此,当单步可靠性已经较高,例如超过约 80% 时,单步可靠性的一点提升,就可能大幅延长能够可靠执行的时程。反过来看,最终一步很自信,并不能说明整条长轨迹可靠,因为前面的薄弱环节可能早已决定了任务失败。
历史会成为未来的上下文
上面的独立性假设已经相当乐观。真实 Agent 会不断以自己的历史为条件进行推理。如果它把一个错误的中间结果写入记忆,之后每一步都会基于这个错误结果运行,随着轨迹变长,错误率甚至可能上升,而不是随经验增长而下降(Sinha et al., 2025)。
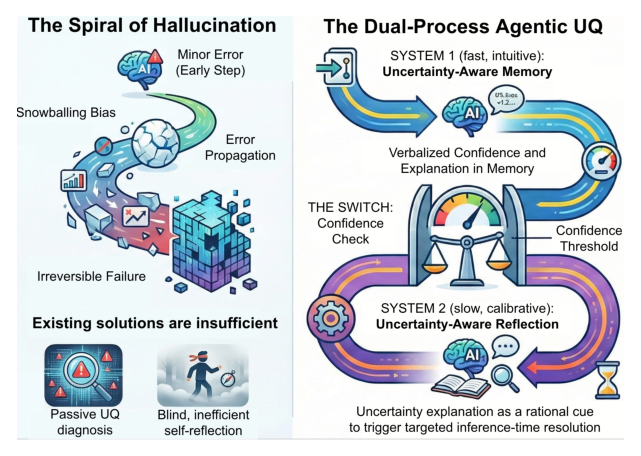
AUQ 把这种现象称为幻觉螺旋(Spiral of Hallucination):早期的认知错误,变成后续步骤的有效环境的一部分(Zhang et al., 2026a)。History-Echoes 从机制上给出互补解释:先前的幻觉会通过影响隐藏状态轨迹,在几何上“困住”后续生成(Simhi et al., 2026)。同一种失败会出现在不同环境中:
- E1:Agent 早期误读一条来源,随后整份报告都围绕这个错误展开。
- E2:Agent 假定了错误的订单编号,后续看似“正确”的工具调用都作用于错误对象。
- E3:Agent 误诊失败测试,之后一直修改错误模块。
关键观察——可靠性的基本单位是轨迹。 一个过度自信的中间步骤,可能比一句过度自信的最终回答更危险,因为中间结果会写入上下文,影响所有下游决策。
不确定性来自多个来源
在单轮模型中,不确定性主要针对模型自己的输出分布。在 Agent 中,环境是第二类重要来源。工具可能因为认证、限流或超时而失败,也可能返回噪声、过期信息,甚至悄无声息地返回错误结果。模型对自己文本的 next-token uncertainty,与外部工具结果是否可靠,根本不是同一个对象;把两者混为一谈,是一种常见设计错误。MESA-S 显式区分了自我置信度(self-confidence)与来源置信度(source-confidence),前者针对模型自身的确定程度,后者针对检索或外部证据的可信度(Unlu, 2026)。
单轮 UQ 方法不能直接照搬到 Agent
LLM 不确定性工具箱——token 概率、语义熵、自一致性、语言化置信度、隐藏状态探针、保形预测封装——是良好的基础,但交互式 Agent 会带来四种具体挑战:
- 没有 logprobs。 很多前沿模型不开放 token 概率,最强的 Agent 也就无法使用依赖这些概率的方法。
- 长文本稀释。 关键工具参数中的低概率 token,可能被几百个流畅的推理 token 平均掉。
- 采样成本。 对一个问题采样十个回答很便宜,对一项任务采样十条完整工具轨迹,却可能难以承担。
- 观测异质性。 输入来自用户、API、网页、文件系统与其他 Agent,每一种都有自己的分布。
两篇立场文章直接讨论了这些问题。Kirchhof 等认为,面对交互式 Agent,需要重新审视偶然不确定性与认知不确定性的二分法(Kirchhof et al., 2025);Oh 等给出 Agent UQ 的一般形式化,并指出细粒度 benchmark 的缺失(Oh et al., 2026)。另一篇综述概括了本文所依据的更大趋势:不确定性从被动指标转变为主动控制信号(Zhang et al., 2026c)。
表达置信度不等于依据它行动
即使一个数字经过校准,如果 Agent 忽视它,也没有用;实际情况往往是,原始数字本身就未经过校准。Agentic Overconfidence 在执行前、执行中和执行后询问 Agent 对成功概率的估计,发现明显的过度自信:Agent 对最终失败的任务仍然保持高置信度(Kaddour et al., 2026)。
RiskEval 揭示另一半问题:即使模型在语言上表达了不确定性,其决策也未必忠实于这个判断。当弃答在效用上更优时,它们仍然不会弃答(Wang et al., 2026a)。关于“置信度与行动不一致”的研究也得到类似结论(Pal et al., 2025)。
由此,本文的主线是:测量 → 校准 → 行动 → 反馈。
小结。 长时程 Agent 需要经过校准的不确定性,因为错误会累积,历史会束缚后续推理,环境也会引入不确定性,单轮置信度在交互中可能失效。一个分数只有真正改变 Agent 的行为,才有价值。
问题设定与 Agent 不确定性的形式化表达
讨论方法之前,需要足够精确的定义,才能比较不同方法。本节集中介绍必要符号,之后仍以直观解释为主。
把 Agent 看作部分可观测过程
可以把一个 Agent 建模为部分可观测马尔可夫决策过程(POMDP):状态空间为 \(\mathcal{S}\),动作空间为 \(\mathcal{A}\),观测空间为 \(\mathcal{O}\),状态转移核为 \(\mathcal{T}(s_{t+1}\mid s_t,a_t)\),奖励或验证器为 \(R\)。Agent 不能直接看到真实状态 \(s_t\),只能依据交互历史:
\[h_t = (o_0, a_0, o_1, a_1, \dots, o_t),\]通过以历史为条件的策略 \(\pi(a_t \mid h_t)\) 选择行动。由于无法观察真实状态,它实际上维护着一个隐式信念(belief):
\[b_t(s_t) = P(s_t \mid h_t).\]这给“可靠性失败”一个直观定义:Agent 的信念 \(b_t\) 已经偏离真实状态 \(s_t\),但策略仍然像没有偏离一样继续行动(Zhang et al., 2026a)。Agentic UQ 的任务,是估计应该多大程度上信任 \(b_t\),以及这种信任如何随时间传播。
在实践中,还需要一种推广。在客户服务场景 E2 中,用户也是一个行动者,有自己的工具与策略。因此,更合适的模型是双控制的去中心化 POMDP(Dec-POMDP),τ²-bench 对此进行了形式化(Barres et al., 2025)。双控制更困难,因为 Agent 还需要考虑用户状态与用户动作的不确定性。
偶然不确定性与认知不确定性为什么会纠缠
经典 UQ 把不确定性分成两类(Kendall & Gal, 2017):
- 偶然不确定性(aleatoric uncertainty):环境中不可消除的随机性,例如不稳定的工具或随机变化的用户行为。仅仅增加数据,无法消除它。
- 认知不确定性(epistemic uncertainty):Agent 自己的无知,例如知识缺口或推理错误。通常可以通过更好的信息或推理来减少。
在一次性预测中,这两类比较容易区分;在 Agent 中,它们会随时间纠缠。假设 E2 的 Agent 不确定用户说的是哪件商品,这属于认知不确定性。如果它直接猜测,并把这个猜测写入 \(h_t\),之后每一步就把猜测当作“给定”的上下文。于是,Agent 自己的认知错误,变成后续轨迹面对的一种有效环境约束。这里并不是说错误在本体上变成不可消除的随机性,而是说,下游决策在没有重新验证时,会把它当作既定事实。这种时间耦合正是单步标量不足以描述 Agent 风险的原因,也是幻觉螺旋的起点。
因此,一些研究认为,直接用 aleatoric/epistemic 二分法设计 Agent 并不够实用。更可操作的分类,是问:Agent 下一步应该做什么?(Ojewale et al., 2026)
- 任务描述缺口(specification gap):缺少理解用户意图所必需的信息。→ 提问。
- 验证缺口(verification gap):无法确认前置条件或操作结果。→ 验证。
- 授权缺口(authority gap):下一步是高影响或不可逆的操作,但没有授权。→ 暂停或升级处理。
- 还有一类隐含问题:工具失败不确定性,即工具返回了错误或空结果。
另一条轴是分布偏移(distribution shift)。在一种任务组合上校准的置信度模型,换到另一种任务上可能失效:领域偏移,例如 QA 转向编码;工具偏移,例如搜索 API 噪声变大;时间偏移,例如证据过期;Agent 架构偏移,例如同一基础模型换了 planner 或 memory。后文会讨论校准器何时能够迁移(Zhang et al., 2026b);post-training 视角则进一步讨论校准在分布变化下的遗忘。
单步不确定性与轨迹级不确定性
令 \(F_t\) 表示 Agent 在第 \(t\) 轮的决策,可以是动作,也可以是动作与观测的组合。对于以熵为基础的不确定性度量,自回归链式法则给出一个精确分解(Malinin & Gales, 2021):
\[H(F_{1:T}) \;=\; \sum_{t=1}^{T} H\!\left(F_t \mid F_{<t}\right).\]每个条件项都与当前步骤自身的不确定性以及历史上下文有关。其他实用分数,例如语言化置信度、探针分数或验证器信号,并不会自动满足这条等式;它们需要显式的聚合规则与经验校准(Oh et al., 2026)。这一表达最清楚地说明:单轮 UQ 只是 \(T=1\) 的特殊情况,而 Agent 需要更完整的描述。
正向传播与逆向校准
AUQ 将 Agent UQ 组织成两个耦合的问题(Zhang et al., 2026a)。
正向问题——传播。 令 \(E_t\) 表示当前局部决策正确,\(V_t \in \{0,1\}\) 表示到第 \(t\) 步为止的轨迹仍然有效。由于 \(V_t\) 对应联合事件 \(V_{t-1} \cap E_t\),在同一历史条件下,精确分解为:
\[\begin{aligned} P(V_t{=}1 \mid h_t) &= c_t\,P(V_{t-1}{=}1 \mid h_t),\\ c_t &= P(E_t{=}1 \mid V_{t-1}{=}1,h_t). \end{aligned}\]其中,\(c_t\) 是以前缀有效为条件的局部置信度;另一项是在当前证据下,对历史轨迹有效性的判断。
对于在线控制器,一个实用代理是递推 \(q_t \approx c_t q_{t-1}\),从而得到 \(q_t \approx \prod_{i\le t} c_i\);也可以使用较保守的最弱环节分数 \(\min_{i\le t} c_i\)。这个代理单调不增,能够揭示幻觉螺旋:一个接近零的步骤,可能污染后面整条轨迹。
但需要区分:后验概率 \(P(V_t\mid h_t)\) 并不一定单调下降。新出现的验证证据,或者成功的错误恢复,可能使它上升。如果 Agent 能修复早期错误,这个区别就很重要。
具体例子 E2。 零售 Agent 经过六步处理退货,各步局部置信度为 \(c = (0.97,\, 0.62,\, 0.95,\, 0.96,\, 0.98,\, 0.99)\)。其中第二步——“识别客户说的是哪笔订单”——明显不稳定,却被其他高置信度步骤包围。直接取平均值得到 \(0.91\),看起来很安全;但乘积代理 \(\prod_i c_i \approx 0.53\),最弱环节 \(\min_i c_i = 0.62\),都会发出明显警告。没有新证据或显式恢复时,后续的自信不应抹去第二步的风险。因此,我们需要用乘积或最小值等方式聚合,再校准结果,并据此触发验证或反思。
逆向问题——校准。 当正向估计低于阈值,即 \(P(V_t\mid h_t) < \delta\) 时,Agent 不应该只报告低置信度,而应该采取恢复行动。将成功视为最优性变量 \(\mathcal{O}\),纠正动作可以表达为后验优化:
\[\begin{aligned} a^\star &= \arg\max_a \int P(a \mid z,h_t)\\ &\qquad\qquad P(z \mid \mathcal{O}{=}1,h_t)\,dz. \end{aligned}\]这里 \(z\) 是潜在推理路径。在实践中,可以用推理时计算来近似,例如反思、best-of-\(N\) 或扩大检索范围。这是从测量不确定性走向依据不确定性行动的形式化桥梁。
校准与区分能力的区别
两种不同的能力经常都被称为“校准”。
校准(calibration)关注:置信度为 0.8,是否对应约 80% 的经验成功率?常见指标是在 \(M\) 个分箱上计算预期校准误差:
\[\text{ECE} \;=\; \sum_{m=1}^{M} \frac{|B_m|}{N}\,\big|\,\text{acc}(B_m) - \text{conf}(B_m)\,\big|.\]区分能力(discrimination)关注:这个分数能否把成功轨迹排在失败轨迹前面?通常用不依赖阈值的 AUROC 衡量。Brier score:
\[\frac{1}{N}\sum_i (C_i - y_i)^2,\]是一种恰当评分规则(proper scoring rule),同时反映校准与区分相关的表现。
这个区别很重要,因为两者可能不一致。一个模型在平均意义上经过校准,却无法区分成功与失败,对路由就没有帮助;另一个模型很擅长排序,却给出错误的概率数值,也无法直接支撑风险预算。对于 Agent,这些指标都应该在轨迹级计算:把回答是否正确替换为轨迹是否成功 \(y \in \{0,1\}\),把单个回答的置信度替换为聚合后的轨迹信念 \(C(\tau) = \Phi(c_{1:T})\)。
不同类型的长时程 Agent
还需要明确本文所说的“Agent”。第一波主要是 ReAct 闭环——推理、行动、观察、重复(Yao et al., 2022);之后加入 Tree of Thoughts 等显式搜索(Yao et al., 2023),以及语言化自我反思(Shinn et al., 2023)。今天的 Agent 类型更加广泛,而有用的不确定性信号会随类型改变:
| Agent 类型 | 相对可信的信号 | 常见行动 | 自我改进产物 |
|---|---|---|---|
| 编码或软件工程 E3 | 测试、符号等价簇、补丁验证器 | 验证、弃答、提问 | 可复用修复或评估规则 |
| 工具使用 E2 | 与工具类型相关的语言化置信度、缺失参数 | 提问、调用、跳过、验证 | 工具 schema 记忆 |
| 推理或长 CoT | 自确定性、局部置信度、熵 | 提前停止、过滤、投票 | 更好的搜索策略 |
| 计算机操作或网页 | 多次采样点击位置的空间分散程度 | 执行、弃答、级联 | UI 记忆或更安全的策略 |
| 深度研究 E1 | 经过校准的停止置信度、证据覆盖率 | 继续、停止、验证 | 研究记忆或来源启发式 |
| 自我演化 | 失败、不稳定性、低置信度 | 写入记忆、增加技能、探索 | 技能库或 Agent 记忆 |
表 1. 不同 Agent 共享控制闭环,但不能共享一个未经检验的“可信信号”。原始 token logits 对某些类型有用,对代码或 GUI 点击等任务则可能很弱。
关键观察——环境与动作空间决定信号选择。 通用的 Agent 校准理论必须尊重 Agent 的动作空间。“直接读 logprobs”对推理 Agent 可能有帮助,对浏览器点击 Agent 却未必合适。
小结。 Agentic uncertainty 涉及意图、状态、工具、动作后果和轨迹有效性。它需要按步骤分析、保留历史风险,并明确粒度与指标:单步还是整条轨迹,概率校准还是成功失败的区分能力。新的验证或恢复证据,仍然可以改变对轨迹有效性的判断。
测量和校准轨迹不确定性
有了问题设定,闭环的前半部分就是:得到一个确实能够反映轨迹成功率的 \(C(\tau)\)。这可以拆成三件事:读取什么信号,如何沿时间组合这些信号,以及如何校准组合结果。ACC/HTC 是将三者连接起来的具体例子。
哪些信号可以表示置信度
| 信号 | 黑盒 API 能否使用 | 对 Agent 的适用性 | 主要失败模式 |
|---|---|---|---|
| 语言化置信度 | 可以 | 部分场景可用 | 过度自信,或被策略忽视 |
| Token logprob 或困惑度 | 往往不可以,概率可能被隐藏 | 有限 | 长度偏差,关键 token 被平均掉 |
| 语义熵 | 可以,但需要采样 | 成本较高 | 整条轨迹的采样昂贵 |
| 自一致性或自确定性 | 可以,具体自确定性实现可能需要分布信息 | 成本较高 | 一致也可能来自共同偏差 |
| 隐藏状态探针 | 不可以直接用于黑盒 | 有潜力 | 依赖具体模型与标注数据 |
| 过程或轨迹特征 | 部分可以 | 较强 | 需要轨迹日志与标签 |
表 2. 常见单轮信号,以及将它们用于 Agent 后面临的约束。
语言化置信度。 要求模型输出一个标量,而且对于 Agent,最好同时输出一段解释。形式上,这是一个提取映射 \(\Phi: h_t \mapsto (a_t, \hat{c}_t, \hat{e}_t)\),得到动作、置信度 \(\hat{c}_t \in [0,1]\),以及自然语言理由 \(\hat{e}_t\)。这种方式兼容黑盒前沿 API,因此很有部署吸引力。
研究表明,模型可以学习用语言表达经过校准的不确定性(Lin et al., 2022);对于经过 RLHF 的模型,“直接询问”可以是一种有用的置信度提取策略(Tian et al., 2023);但提取结果是否可靠,很大程度取决于如何询问(Yang et al., 2024)。同一类自评估方法,例如询问 \(P(\text{True})\),可以追溯到 Kadavath et al., 2022。
不过,置信度仍然是模型输出,可能被扭曲。TASR 在其研究设置中发现,RLHF 模型的语言化 1–5 级置信度发生塌缩,因此停止规则改用经过校准的 logit margin(Kieback et al., 2026)。
Token logprobs。 当概率可用时,序列置信度常用长度归一化对数似然:
\[\frac{1}{L}\sum_{j=1}^{L}\log p(y_j\mid y_{<j}).\]它计算便宜,却常常与语义正确性不一致。在代码生成中尤其明显:token 置信度对代码正确性的预测较差,而基于符号等价类的方法表现更好(Sharma & David, 2025)。
语义熵。 采样多个回答,按语义而不是表面字符串进行聚类,再计算语义簇上的熵(Kuhn et al., 2023)。这一方法适合单轮 QA,但当每个“样本”都变成完整多步轨迹时,成本会显著增加。
自确定性与自一致性。 多条采样推理路径之间的一致程度,可以作为隐式置信度(Wang et al., 2022)。Self-certainty 则通过输出分布与均匀分布之间的 KL 散度,衡量分布的集中程度,提供一种不依赖 reward model 的质量信号(Kang et al., 2025)。
总之,Agent 需要一种在接口与成本限制下,既有意义又负担得起的信号。最好,这个信号还包含足够的语义信息——不仅有 \(\hat{c}_t\),还有 \(\hat{e}_t\)——能够告诉控制器,究竟应该如何处理这个不确定性。
把单步不确定性聚合成轨迹不确定性
给定各步置信度 \(c_1,\dots,c_T\),如何得到轨迹信念 \(C(\tau)\)?常见算子包括:
- 最后一步:\(C=c_T\)。容易读取,但忽视早期失败。
- 平均值:\(C=\frac{1}{T}\sum_t c_t\)。平滑,但平滑恰好可能掩盖关键风险。
- 最弱环节或最小值:\(C=\min_t c_t\)。较保守,能够保留薄弱步骤的警告。
- 乘积:\(C=\prod_t c_t\)。在各步成功独立等简化假设下,对应整条轨迹全部成功的概率。
- 学习得到的聚合:\(C=f(\phi(\tau))\)。使用整条轨迹的特征,下一节进一步讨论。
关键观察——平均值会掩盖决定性失败。 Agent 的失败可能稀疏,却具有决定性。如果一次工具调用已经悄悄污染了轨迹,后面九步的高置信度不应该把这一风险平均掉。因此,乘积或最小值是值得考虑的风险代理,但仍需要经验校准,并考虑纠错能力。
E2:如果 Agent 在“查找正确订单”这一步的置信度骤降,即使之后“发放退款”看起来很自信,整条轨迹的信念也应该保留这个风险。
传播与历史不确定性的继承
聚合通常对称地看待各步;传播则建模不确定性如何从历史中继承。SAUP 用情境权重传播每一步的不确定性,对关键步骤赋予更高权重,相比只看最后一步的基线,改善失败排序(Zhao et al., 2024)。
UProp 提供信息论视角,把一步决策的不确定性分成内在项与从历史继承的外在项:
\[U(d_t) = H(d_t \mid h_t) + I(d_t;d_{<t}).\]第一项是当前步骤的内在不确定性;第二项是从历史继承的外在不确定性。
该方法在依赖轨迹的决策过程中估计互信息项(Duan et al., 2025)。这表达了一个重要思想:不只是当前这一步看起来不可靠,前面步骤的不确定性也可能使它不可靠。
整体轨迹校准
ACC 不再只手动选择一个聚合规则,而是提出一个监督学习问题:给定完整轨迹,预测它能否成功(Zhang et al., 2026b)。它将问题称为 Agentic Confidence Calibration,并提出整体轨迹校准(Holistic Trajectory Calibration,HTC):把原始置信度轨迹转化成四组紧凑的过程特征:
- 动态(Dynamics):置信度如何随步骤演变,例如趋势、反转与梯度。
- 稳定性(Stability):单步内部 token 或置信度分布的波动。
- 位置(Position):早期与后期指标,例如第一步和最后一步的信号。
- 结构(Structure):步骤数、token 长度模式等复杂度代理。
这些特征进入一个刻意保持简单、可解释的校准器:
\[\mathcal{C}_\tau = \sigma(\mathbf{w}^\top \phi(\tau) + b),\]并采用 L2 正则化的完整版本,或 L1 正则化的稀疏版本。简单是一种设计优势:Agent 轨迹数据集通常规模小、采集昂贵,低容量模型较不容易过拟合;同时可以检查权重,理解哪些信号能够预测失败。
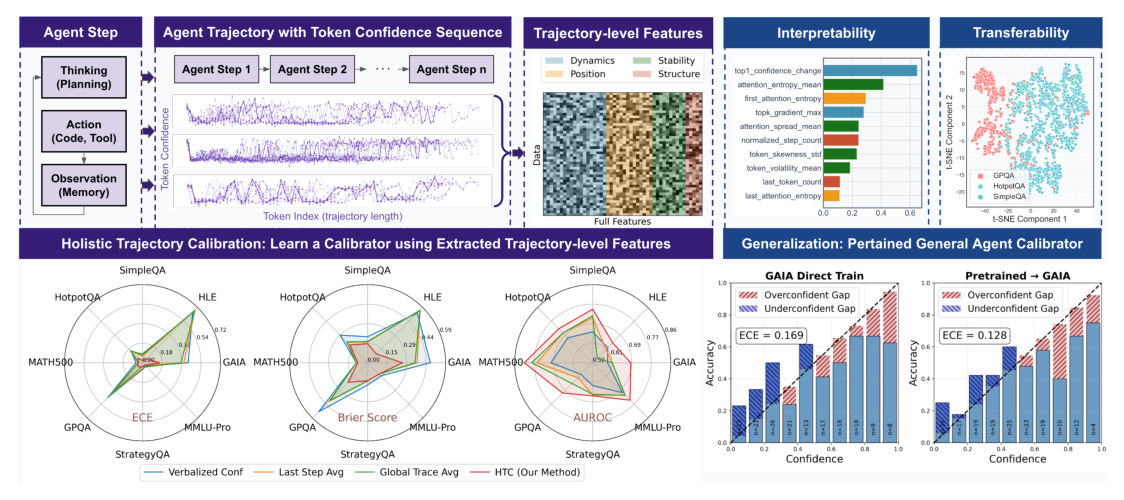
观察过程确实有帮助,而且在困难任务上尤其明显。 在 ACC 报告的实验中,HTC 相对最后一步置信度的优势,在困难任务上更大。Humanity’s Last Exam(HLE)上,原始语言化置信度的 ECE 为 0.656;最后一步 token 概率加温度缩放的 ECE 为 0.436;HTC-Reduced 则达到 ECE 0.031,相对经过调优的最后一步基线降低约 14 倍,同时 Brier score 相当或更好。
| 校准误差 ECE,越低越好 | SimpleQA | GPQA | HLE |
|---|---|---|---|
| 语言化置信度 | 0.121 | 0.454 | 0.656 |
| 最后一步 token 概率加温度缩放 | 0.071 | 0.139 | 0.436 |
| HTC-Reduced,ACC | 0.068 | 0.102 | 0.031 |
表 3. ACC 主结果的一部分:使用过程特征能够改善校准,在困难任务上差距更明显。来源:Zhang et al., 2026b,Table 1。
三个发现不只适用于某一组特征:
- 可解释性。 最有预测力的信号随任务变化。位置特征对长而困难的推理链更重要;多步 QA 则更依赖动态、稳定性与位置的组合。但“先看起点与终点,再看过程稳定性”的层次反复出现。由于校准器是线性的,可以直接从权重观察这些关系。
- 可迁移性。 当输出格式一致时,在一个任务上训练的校准器能够迁移到相关任务。例如,SimpleQA 上训练的校准器迁移到 HotpotQA,在报告的实验中甚至优于域内校准器。但跨越不同范式,例如从多项选择转到开放式回答时,表现会下降。
- 泛化。 在报告的域外 GAIA 实验中,预训练的 General Agent Calibrator(GAC)获得最佳零样本校准,ECE 为 0.118;相比 LSTM、Transformer 等五类学习基线,在小数据条件下方差更低。
核心结论是:校准应该观察过程,而不只是最后一个 token。 一个小而透明的模型,也可以从轨迹中读出有效信号。
尾部风险与恰当评分规则
还有两个重要补充。TRACER 认为,失败往往稀疏却具有决定性,因此应考虑用尾部风险函数,例如 CVaR 或基于循环、连贯性缺口等情境感知信号的 max-composite,而不只是平均值(Tayebati et al., 2026)。
TPS 则指出,单一轨迹 ECE 标量无法充分反映分辨能力,提出严格恰当的轨迹评分规则,用于评价以完整前缀为条件的成功概率轨迹(Raghu et al., 2026)。实际使用时,可以用轨迹 ECE、Brier 和 AUROC 比较方法,用 reliability diagram 检查,但不要声称一个标量已经“解决”轨迹校准。
根据 Agent 类型选择可信信号
将表 1 落到实际场景:
- 编码 Agent:logits 可能较弱,应结合测试、符号等价簇或补丁验证器,优先考虑“验证或弃答”,而不是盲目编辑(Sharma & David, 2025;Cambronero et al., 2025)。
- 工具使用 Agent:同一个语言化置信度,在不同工具上可能含义不同。网页搜索等证据工具可能引入噪声和过度自信;代码解释器等验证工具则能提供更扎实的反馈(Xuan et al., 2026)。
- 计算机操作 Agent:可信信号可能是空间上的,例如多次采样 GUI 定位点的分散程度,而不是 token 置信度(Wang et al., 2026b)。
- 推理 Agent:局部置信度可以用于控制 test-time scaling(Fu et al., 2025)。
- 深度研究 Agent E1:关键是经过校准的停止置信度:当前证据是否已经足够回答问题?(Kieback et al., 2026)
小结。 轨迹级、过程感知的信号,比只看最后一步更有潜力。ACC/HTC 给出一种通用、可解释的轨迹校准方法,但输入它的局部信号,仍然必须根据 Agent 的任务与动作空间选择。
依据不确定性采取行动
经过校准的数字,只有改变行为之后才有用。Agent 的不确定性策略,远不只是“回答还是拒绝”。
控制器可以采取哪些行动
| 行动 | 触发条件 | 成本 | 判断错误时的风险 |
|---|---|---|---|
| 继续或执行 | 高置信度、低风险 | 低 | 过度自信地失败 |
| 提问或澄清 | 任务描述缺口 | 打断用户 | 不必要的打扰 |
| 验证或收集证据 | 验证缺口、工具结果可疑 | 工具调用成本 | 陷入验证循环 |
| 反思或自我纠错 | 推理或计划不确定 | 模型调用 | 为错误计划编造确认理由 |
| 分配更多计算 | 有希望但尚未解决 | 延迟与 token | 浪费计算 |
| 弃答或延后 | 低置信度或高风险 | 降低覆盖率 | 过度拒绝 |
| 升级处理 | 超出模型或工具预算,或存在授权缺口 | 人类或更强模型的成本 | 形成处理瓶颈 |
表 4. 不确定性作为带类型的路由信号。关键不是一个统一标量阈值,而是依据不确定性的类型选择行动。
弃答。 AbstentionBench 表明,即使前沿模型也没有彻底解决弃答问题;值得注意的是,reasoning fine-tuning 在其研究中甚至会降低弃答能力(Kirichenko et al., 2025)。Abstain-R1 则将弃答与拒绝后的澄清,视为需要专门学习的行为(Zhai et al., 2026)。
提问。 如果不确定性来自任务描述缺口,正确动作应该是询问,而不是默默反思。UoT 根据预期信息增益决定问什么,可近似表达为:
\[\begin{aligned} q^\star &= \arg\max_q \big[H(\text{answer})\\ &\qquad - \mathbb{E}_{r\sim q}H(\text{answer}\mid r)\big]. \end{aligned}\]也就是选择最能降低答案不确定性的问题(Hu et al., 2024)。SAGE-Agent 将澄清推进到工具参数空间,并用完全信息的期望价值,判断何时应该停止询问(Suri et al., 2025)。在编码场景 E3 中,Ambig-SWE 表明,有针对性的澄清问题能够挽救相当一部分描述不完整的任务(Vijayvargiya et al., 2025)。
反思。 Reflexion(Shinn et al., 2023)与相关 self-refinement 方法,通过语言反馈改善 Agent。但盲目反思可能低效,甚至有害。真正的问题是何时反思,这也是经过校准的不确定性能够发挥作用的地方。
分配计算或停止。 DeepConf 利用局部置信度控制推理计算与提前停止(Fu et al., 2025);TASR 在不额外训练模型的情况下,用经过校准的停止规则控制迭代检索(Kieback et al., 2026)。
路由或升级处理。 AutoMix 通过自验证元控制器,将不确定的查询交给更强模型(Aggarwal et al., 2024)。KnowNo 给出机器人版本:用保形预测决定何时求助,在其统计假设下提供任务完成保证,并且只在预测集为单元素时自主行动(Ren et al., 2023)。
双过程 Agentic UQ
ACC 告诉我们一条轨迹有多可靠;AUQ 将这个信号转化为行动。它是“不确定性作为开关”的具体实现,而且不需要额外训练基础模型(Zhang et al., 2026a)。它通过双过程控制器,实现前文的正向与逆向分解:
- System 1——不确定性感知记忆(Uncertainty-Aware Memory,UAM)。 每一步,Agent 输出 \((a_t,\hat{c}_t,\hat{e}_t)\),并把置信度与解释写入记忆:
保留先前的疑虑,相当于给过度自信增加一个软性阻尼器,帮助不确定性沿轨迹向前传播。
- System 2——不确定性感知反思(Uncertainty-Aware Reflection,UAR)。 开关函数 \(S(h_t)=\mathbb{I}[\hat{c}_t < \tau]\),只在置信度低于阈值 \(\tau\) 时触发反思。反思由解释 \(\hat{e}_t\) 引导,纠正动作则通过 \(N\) 个样本上的一致性加权投票选择:
当局部反思无法解决问题时,还可以触发自适应记忆扩展作为后备机制。
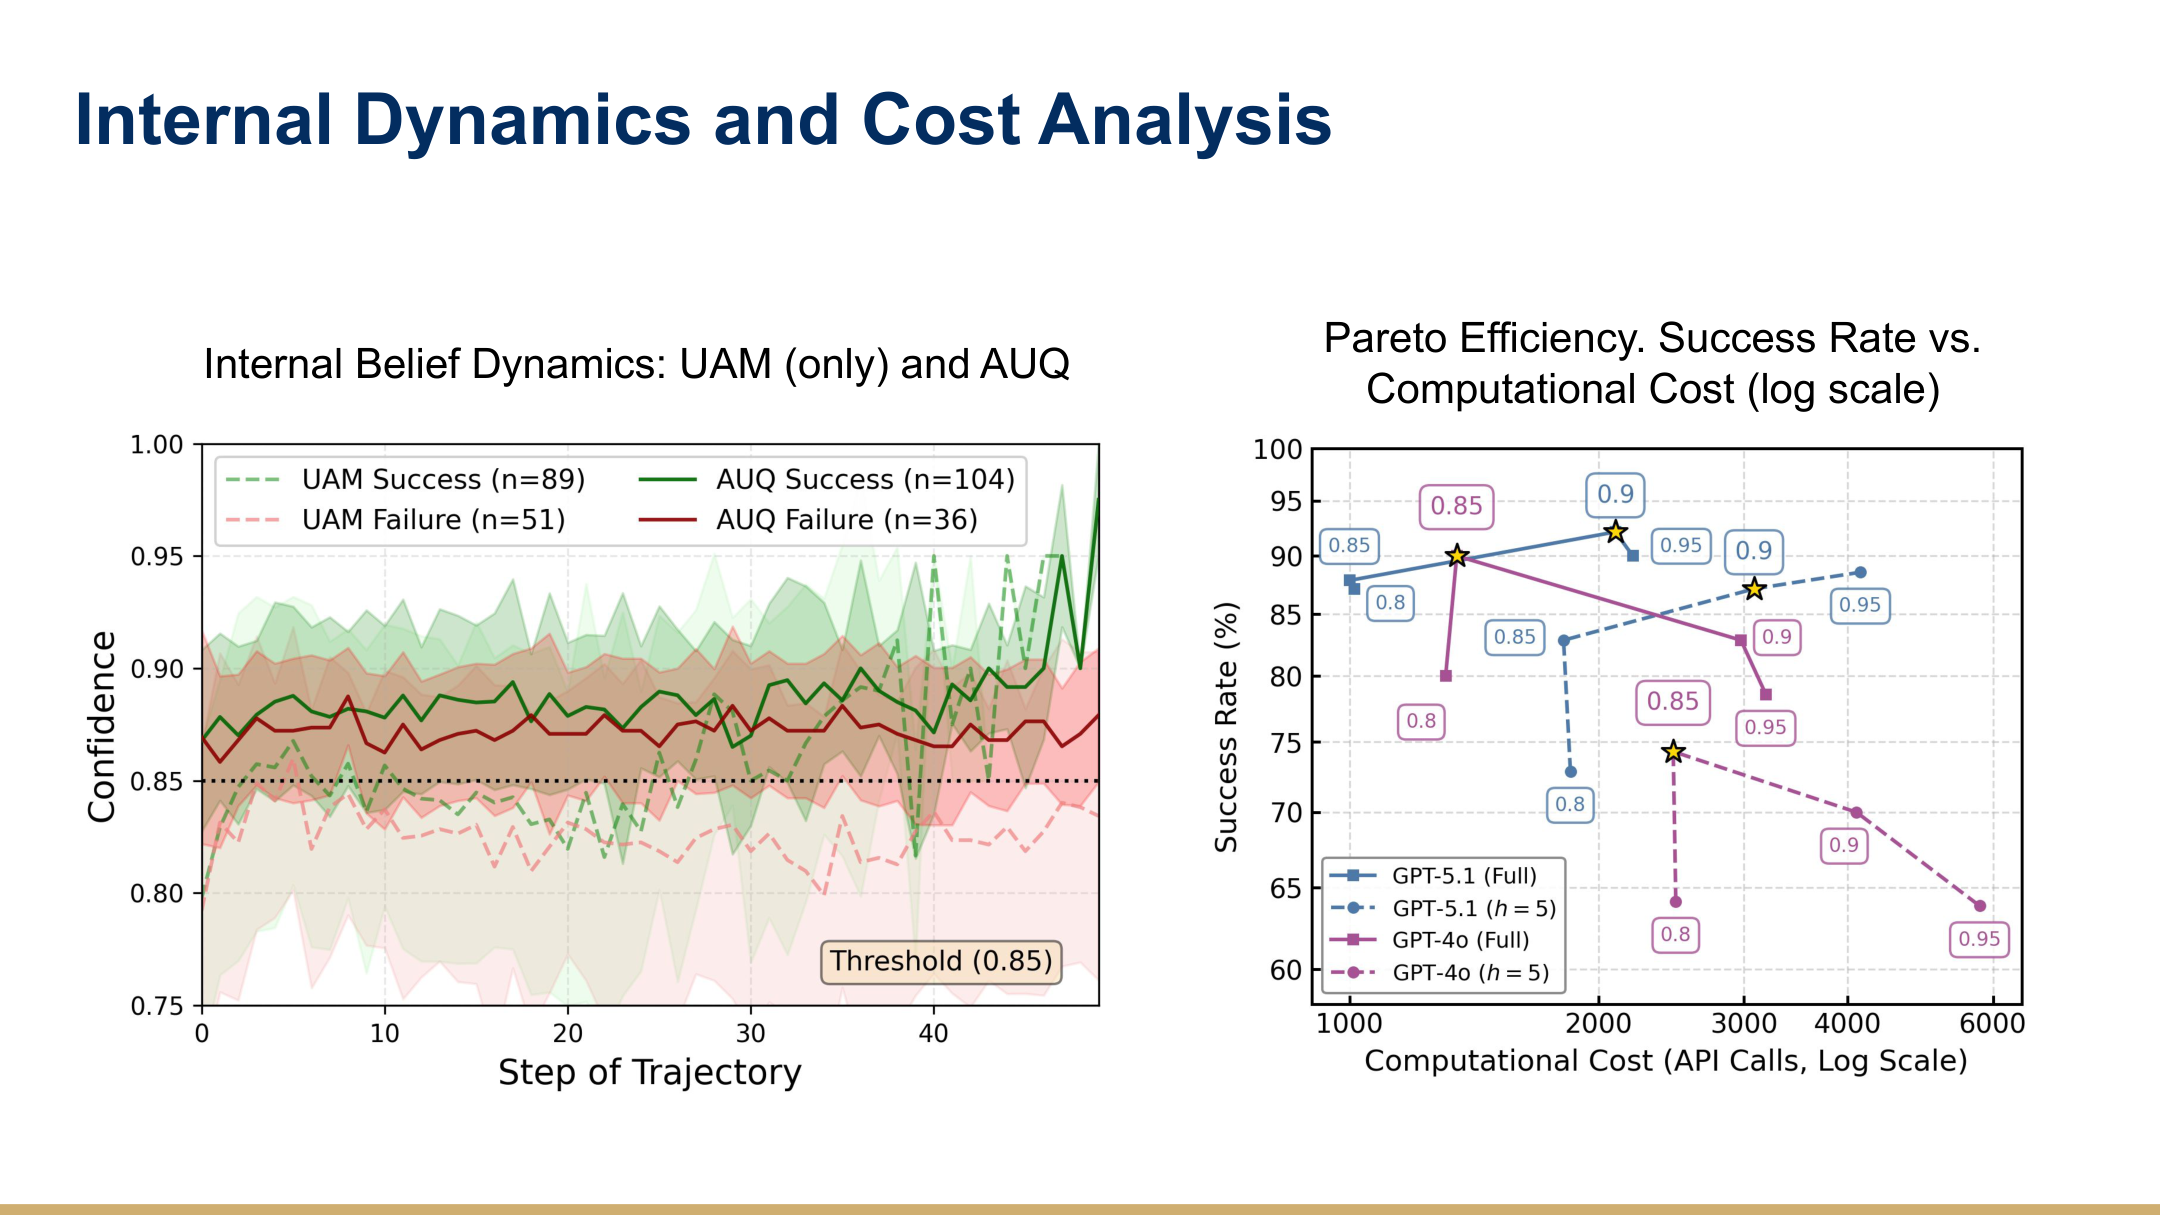
两部分承担不同工作,这一点在消融实验中也能看到。 仅使用 UAM 时,轨迹 ECE 最低,说明它有助于把置信度与现实对齐;仅使用 UAR 时,Brier 表现最好,说明主动解决缺口,能够改善对成功与失败的区分。AUQ 同时保留两者,组合效果体现在下游任务上:
- 在闭环任务中,相对 ReAct System-1 基线,ALFWorld 成功率达到 74.3%,提高 10.7 个百分点;WebShop 达到 42.5%,提高 13.6 个百分点。它也优于自一致性 CoT-SC,因此收益不只是来自额外采样,还来自有针对性的反思。
- 在开放式 DeepResearch Bench 的报告设置中,整体分数为 52.09,高于该比较中表现最强的闭源 Agent(49.71)与开源框架(50.62)。
- 置信度的区分能力也更强,即 AUROC 更高。因此,System-2 预算可以更多投入真正需要处理的轨迹,而不是无差别反思。
与盲目反思相比,差别在于触发条件与修复线索。AUQ 不在每一步都反思,因为这样成本高,也容易产生反复检查的疲劳;它在自身不确定性指出某一步有风险时反思,再用语言解释告诉 System 2 应该修复什么。例如,E1 中的 planner 可以输出:
置信度:0.58。疑虑:我还没有区分日本老年人口预测与人均消费预测,当前计划可能把人口变化和市场规模混在一起。
这比一个单独的 0.58 更可操作:它指出了应该检索的问题,以及需要修改的分解方式。
反思的成本与收益
反思会增加推理开销,但失败轨迹同样昂贵。一个普通 Agent 在第五步做出错误假设,可能又花四十五步追逐这个错误。因此,合适的成本核算不只是原始 token 数,而是每个成功任务的有效成本:
\[\begin{aligned} \text{Cost}_{\text{eff}} &= \frac{\text{total cost of all attempts}}{\text{number of successful tasks}}\\ &= \frac{\text{avg cost per trajectory}}{\text{success rate}}. \end{aligned}\]按照这个指标,单条轨迹投入更多计算,仍然可能降低每次成功的成本,因为它把长期徒劳的失败转化成了成功。
AUQ 同时衡量了收益与开销。在报告的分析中,有针对性的反思纠正了 ReAct 基线失败轨迹中的 14.3%,修复次数明显多于引入新错误的次数,净收益为正。但边际收益迅速递减:超过某个点后,准确率趋于平台,成本却近似指数增长。因此,阈值 \(\tau\) 需要经过权衡选择,而不是越大越好。
置信度门控何时失效
需要认真对待三个限制:
- 幻觉式确认(delusional confirmation)。 模型可能为错误计划编造合理解释,反思反而提高了它的置信度。AUQ 记录了这种失败,因此不能盲目信任反思后的置信度。门控策略应该保守,确保净修复明显多于新引入的错误。
- 门控不稳定。 Same Signal, Opposite Meaning 表明,同一种置信度或难度信号,在某个设置中可能预测额外计算有帮助,在另一个设置中却预测额外计算有害。需要更多计算,不等于适合投入更多计算(Li et al., 2026)。
- 置信度不等于效用。 RiskEval 再次提醒:控制器如果不考虑错误成本,即使风险估计正确,也可能采取错误行动(Wang et al., 2026a)。
关键观察——更多反思不一定更好。 目标不是最大化思考量,而是在正确步骤触发正确干预。不确定性控制器的质量,取决于它所依赖信号的校准质量。
小结。 不确定性只有转化成提问、验证、反思、计算分配、弃答或路由等行动,才真正有用。行动应该根据不确定性的类型选择;门控本身也可能判断错误,因此需要保守设计。
利用不确定性实现自我改进与自我演化
闭环还有最后一段。除了改善当前决策,不确定性还可以让 Agent 系统随时间变得更好,而且无需更新权重。这是应用层的收益:通过记忆、技能与工具实现非参数化自我演化。
不确定性感知记忆。 AUQ 的 UAM 是最简单的例子:不只保存观测和动作,还保存元认知状态 \((\hat{c}_i,\hat{e}_i)\)。解释重要,因为它赋予不确定性语义。“证据互相矛盾”和“用户没有提供日期”,应该引导不同的后续行为。
Oblivion 将这一思路扩展为自适应记忆,用不确定性控制何时检索记忆,以及记忆如何衰减或得到强化(Rana et al., 2026)。Confidence Laundering 则给出系统级警告:如果不确定性没有随组件交接传递,下游模块就会把可疑产物当成确定事实(Shi et al., 2026)。对应的设计原则是:
不确定性应该是 Agent 系统中持久存在的元数据字段,而不是某一次 prompt 中转瞬即逝的一句话。
不确定性驱动的探索。 冻结模型的 Agent 下一步应该把动作预算花在哪里?当预期信息增益高,而且不确定性可以减少时,继续搜索;当更多搜索不会改变答案时,停止;当现有工具无法消除不确定性时,弃答或升级处理。UoT 是“问什么”的推理时实现(Hu et al., 2024);TASR 是深度研究 E1 中“何时停止”的实现(Kieback et al., 2026)。
从失败中生成技能与工具。 Voyager 是经典的非参数化自我演化 Agent:基础 GPT-4 保持冻结,通过自动课程和不断增长、经过自验证的技能库改善表现(Wang et al., 2023)。ExpeL 把跨任务经验整理成可复用的自然语言洞见(Zhao et al., 2023);A-MEM 构建不断演化的 Agent 记忆(Xu et al., 2025)。
它们与不确定性的联系很直接:低置信度提示应该在哪些地方搜集证据;重复失败提示应该补充什么技能;经过验证的恢复经验,正是值得保存的内容。
这也是通向 post-training 视角的桥梁。当系统反复学习到哪些不确定性重要,下一步自然会问:能否把这些行为内化到模型权重中?
小结。 模型权重冻结,并不意味着 Agent 不能变得更可靠。关键是用不确定性决定它记住什么、询问什么、验证什么,以及把什么经验转化成可复用技能。
如何评估 Agent 的校准
评估是这个领域较薄弱的一环,需要单独认真讨论。
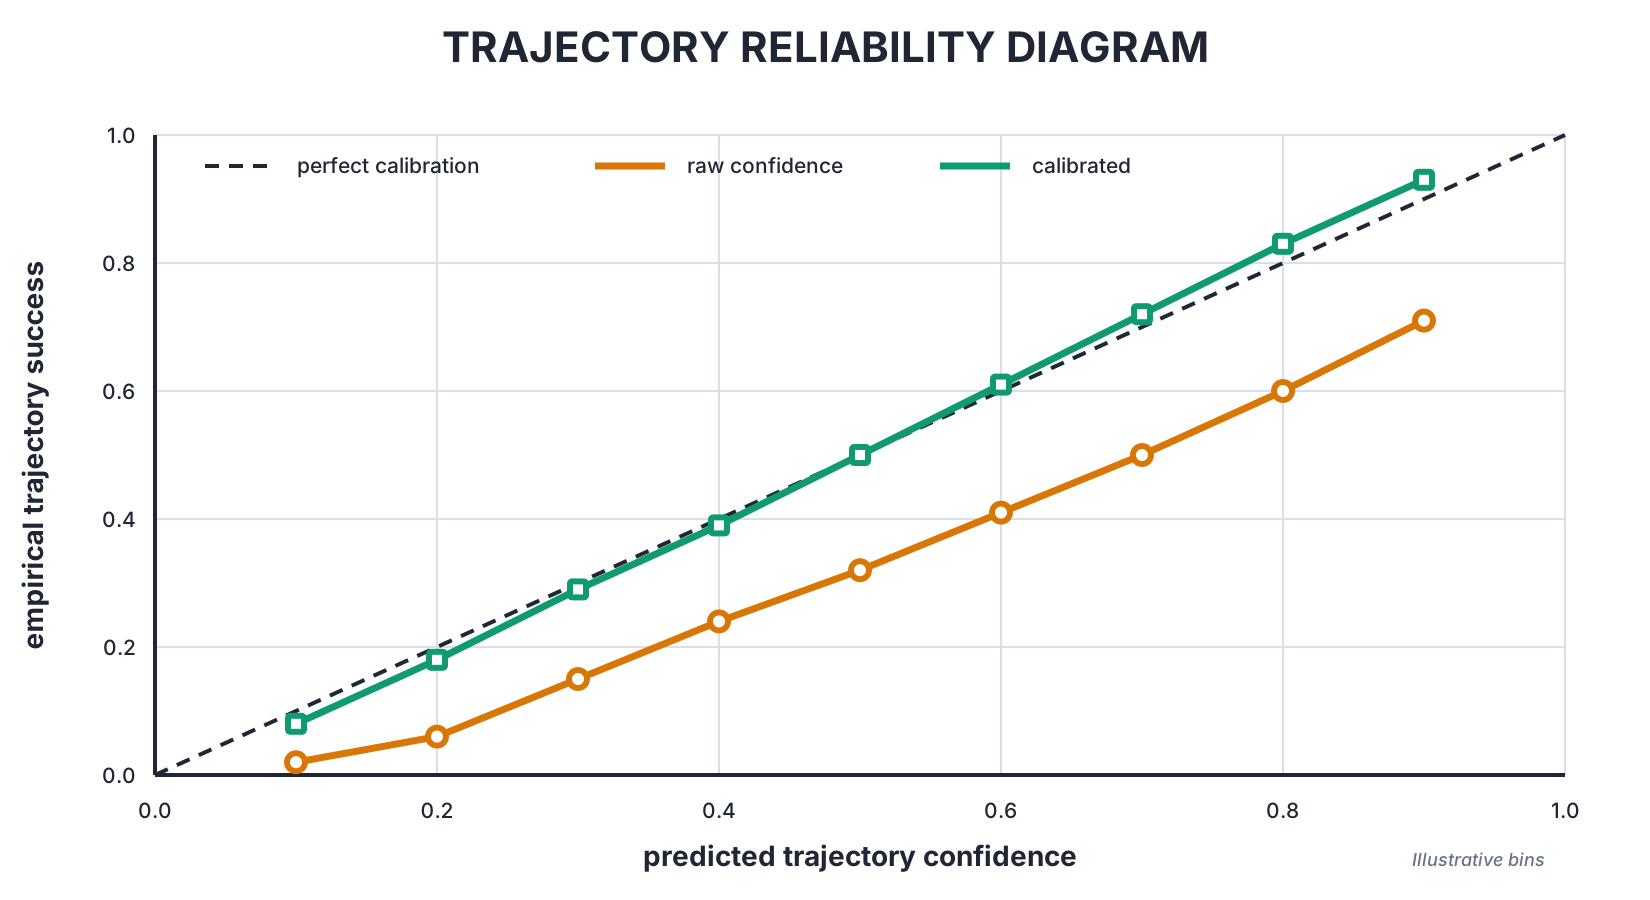
指标。 使用前文定义的轨迹级 ECE、Brier 和 AUROC,再结合选择性执行的 risk–coverage curve。轨迹信念 \(C(\tau)\) 可以取 \(c_T\)、\(\text{mean}_t c_t\)、\(\min_t c_t\),或者学习得到的 \(f(\phi(\tau))\)。选择哪一种聚合方式会影响结果,因此必须报告。Reliability diagram 通常是最有信息量的检查图之一。
Benchmark。 在本文讨论的研究范围内,领域仍然普遍依赖既有 Agent benchmark,而这些 benchmark 往往缺少专门设计的不确定性标签。
| Benchmark | 提供什么 | 对 UQ 的限制 |
|---|---|---|
| τ²-bench | 双控制工具使用任务 | 缺少不确定性标签 |
| GAIA | 深度研究与通用助理任务 | 主要提供轨迹级成功标签 |
| AbstentionBench | 弃答场景 | 以单轮任务为主 |
| Ambig-SWE | 描述不完整的编码任务 | 限于软件工程场景 |
| Argus 与计算机操作 UQ(Kumar et al., 2026) | GUI 定位不确定性 | 特定领域的评估 |
表 5. 研究中常用的评估环境,以及它们无法完整覆盖 Agentic UQ 的原因。
Oh 等分析了数十个 Agent benchmark,发现只有少部分提供单步标签(Oh et al., 2026)。面向 Agentic UQ 的 benchmark 应记录每一步观测、动作、工具输出与失败,模型的置信度和不确定性解释,每步操作是否可逆,阶段性或部分成功标签,以及最终成功情况。
更困难的是,它还应该标注:Agent 是否本来应该提问、验证或升级处理。评估不能只关注任务是否成功,还要检查 Agent 在轨迹中是否做出了合适的不确定性控制决策。
小结。 我们能够测量最终成功率,但对于置信度是否正确跟踪轨迹、是否改善决策,评估仍不成熟。这个 benchmark 缺口本身就是研究机会。
开放问题
这套方法已经有用,但仍然年轻。以下问题值得保持怀疑与关注。
信号本身可能不可靠。 本文中的控制器会放大其输入信号的影响。如果置信度没有校准,就可能在简单情况上反思,跳过困难情况,或者升级错误的任务。Same Signal, Opposite Meaning 表明,信号的含义依赖上下文(Li et al., 2026)。校准门控信号与构建门控本身同样重要。
工具输出的不确定性建模不足。 大多数方法决定是否调用工具,更少的方法判断是否信任工具结果。但 Agent 越来越依赖可能静默失败的工具:过期网页、不完整结果、schema 漂移、认证错误或有歧义的记录。
多 Agent 之间会发生“置信度洗白”。 一个 Agent 的不确定判断,变成另一个 Agent 的高置信度前提。DebUnc 用 attention scaling 研究辩论中的不确定性沟通(Yoffe et al., 2024);Confidence Laundering 将这一问题推广到任意组件交接(Shi et al., 2026)。可靠的多 Agent 系统,可能需要能够跨消息边界传递的不确定性元数据。
反思存在延迟与退化风险。 它增加 token 与墙钟时间,也可能推翻正确计划,产生幻觉式确认。好的控制器应该优化净修复,而不是干预次数;实时 Agent 甚至可能无法承担 best-of-\(N\)。
指标与 benchmark 仍不成熟。 单一轨迹 ECE 无法充分反映分辨能力(Raghu et al., 2026)。我们需要恰当的轨迹评分规则、单步标签、弃答能力指标,以及为 Agentic UQ 专门设计的 benchmark。
外部编排不等于模型内化。 本文在冻结模型周围构建可靠性机制,这有部署价值,也常常必不可少。但如果模型本身就能给出经过校准的判断,这些机制可能更便宜、更简单。配套的 Calibrating Long-Horizon Agents: A Post-Training Perspective 视角,以 calibration-aware on-policy distillation 为重要线索,进一步讨论内化问题(CaOPD;Zhang et al., 2026d)。
小结。 推理时的不确定性控制已经能够发挥作用,但领域仍需要更稳健的信号、考虑工具输出的 UQ、多 Agent 传播、更好的评估,以及最终通过训练实现的行为内化。
总结
长时程 Agent 的失败方式不同于单轮模型:错误会累积,历史会成为未来上下文,置信度需要指导决策,而不只是描述输出。
推理时的设计遵循可靠性闭环:沿轨迹测量不确定性,将它校准到实际成功率,再依据它采取行动——弃答、提问、验证、反思、分配计算或路由——最后把结果反馈到记忆与技能中。ACC/HTC 展示如何校准整条轨迹;AUQ 展示如何把不确定性转化成运行时控制信号;相关的 2025–2026 年研究则提供证据、限制,以及针对不同 Agent 类型的信号选择。
冻结模型的视角已经能够带来很多收益。下一步,是通过 post-training 将这些行为内化到权重中。
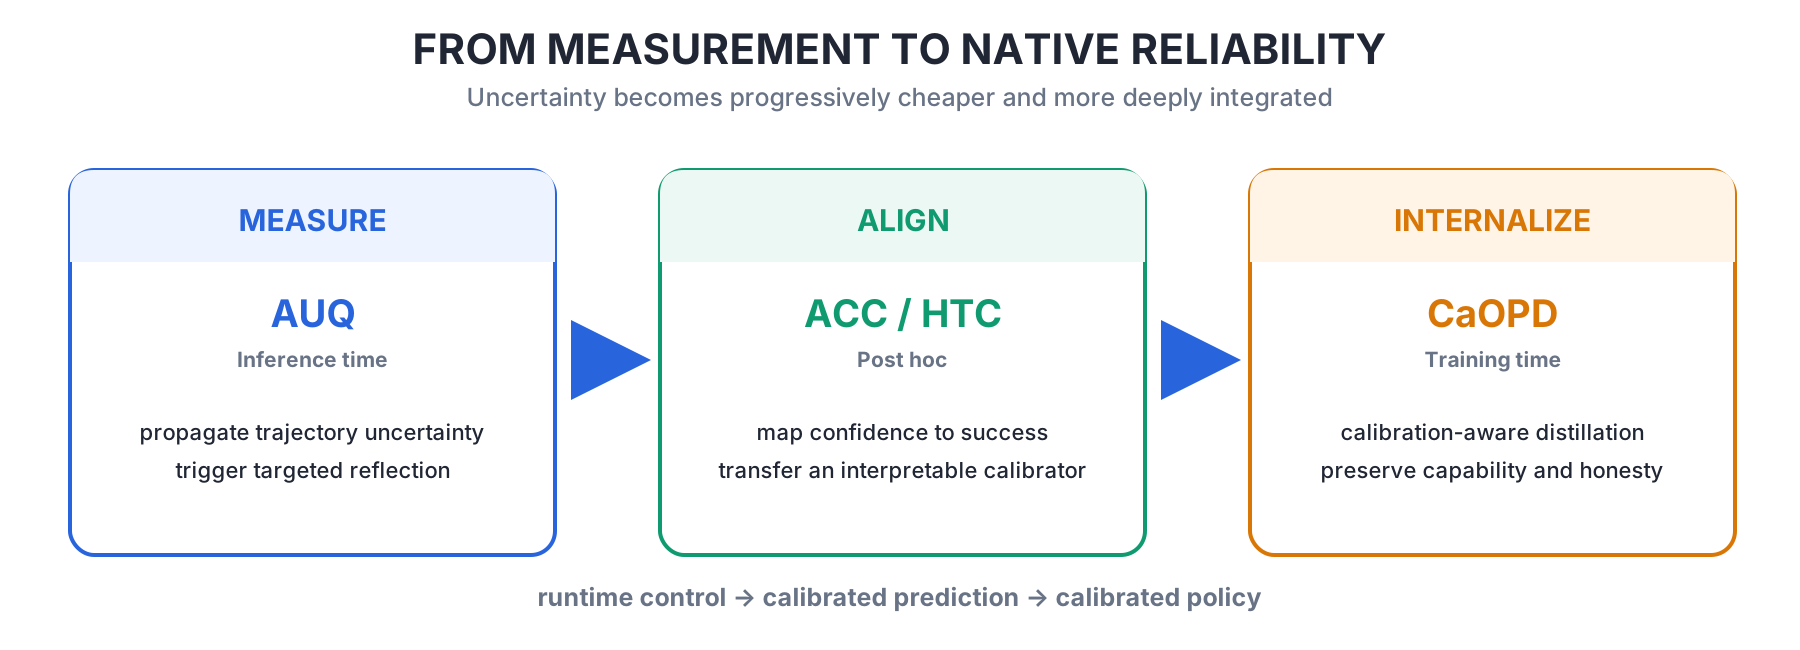
图源说明:图 4 与图 5 来自所引用论文的方法图;图 6 改编自作者的 AUQ 分析 slides;其余图片为作者原创。可复现的矢量图源代码位于 scripts/blog_figures/calibrating_long_horizon_agents.py。中英文版本共用原始图像,图注与正文分别本地化。
10 月 5 日更新 Reflection Beam
更新于 2026 年 10 月 5 日。 Beam 提出了一个与本文有关的重要区分:Reflection 披露的是预测 RL reward improvement,相关系数为 r = 0.79,而 Best-of-N ceiling baseline 为 0.46。这不是一个已经报告的置信度校准结果。(Reflection, 2026)
先确定预测的究竟是什么
| 预测目标 | 回答的问题 | 我会要求的证据 |
|---|---|---|
| RL 后的 reward 增益 | 这次训练干预会改善被评分的行为吗? | Held-out 干预的预测结果与预测误差 |
| 轨迹成功概率 | 这个 Agent 有多大概率正确完成任务? | 对照独立成功标签的 proper scores 与 reliability curves |
| 增加 effort 的价值 | 再多一个 reasoning/tool step 值不值得? | 受控 budget 干预与净效用 |
这是三个不同的预测问题。一个问题上表现好,不会自动证明另两个问题也解决了。
即使预测的尺度不对、存在系统性 bias,correlation 也可以很高。由 judge 定义的 reward 上升,也不一定意味着独立测量的任务正确率提高。对于 agentic calibration,我们仍需要清晰定义的事件、这个事件的概率,以及从被优化的 reward channel 之外获取的标签。
把 confidence 与额外计算的价值联系起来
Reflection 的 accuracy–length 图显示,早期可以做到解法更短、效果更好;后期则由更多 token 支持进一步提升。这提醒我们:“越短越好”并不是普遍适用的训练目标。(Reflection, 2026)
我想探索的研究方向是 conditional value of computation(条件化的额外计算价值),而不只是“confidence 高就停止”。任务成功概率低,可能因为继续思考有帮助,也可能因为 tool 不可用,或者问题本身 underspecified。这些情况应采取不同的行动。
可以从相同 prefix 出发,在几个不同 effort budget 下分支,构建受控数据集。固定 model、tools 和 permissions,测量额外获得的 verified success、增加的 latency,以及 token/tool cost。训练一个预测边际增益的 predictor,再在未见过的任务族上,将其 controller 与固定 budget、随机分配和 confidence-only gate 对比。这样检验的是 uncertainty 能否改善计算分配,而不是它是否仅仅与题目难度相关。
Just Enough Thinking 提供了按 solve rate 调整长度惩罚的相关已有工作。但这不意味着任务成功置信度、局部 token certainty 与 effort 的边际价值是同一个东西。
Policy 或 harness 改变之后,要重新校准
对于更高效的 reasoning policy 或融合后的 student,应联合重做 accuracy–calibration–cost 评测。对于 ACC/HTC 类型的 calibrator,更短的轨迹可能改变 token count 等过程特征的含义。对于 CaOPD 类型的干预,要显式检验 calibration 是否能保留到新的 data mixture 与 deployment context。对于 AUQ 类型的 controller,要衡量 verification 和 reflection 的净收益,包括不必要干预把正确答案改坏的情况。这些是建议实验,不是 Beam 已报告的结果。
要点。 Beam 启发我们把训练增益的可预测性与 runtime compute decision 联系起来,但目前不能据此认为它的 confidence 已经过校准,也不能把它当成 Jev/RLCD 式概率训练的证据。
如何引用
Zhang, Jiaxin.(2026 年 6 月). 长时程 Agent 的校准:推理时的置信度与不确定性. Jiaxin Zhang’s Blog.
BibTeX:
@article{zhang2026calibratingagentszh,
  title   = {长时程 Agent 的校准:推理时的置信度与不确定性},
  author  = {Zhang, Jiaxin},
  journal = {Jiaxin Zhang's Blog},
  year    = {2026},
  month   = {Jun},
  url     = {https://jxzhangjhu.github.io/blog/2026/calibrating-long-horizon-agents-zh/},
  note    = {Chinese translation of Calibrating Long-Horizon Agents: Confidence and Uncertainty at Inference Time}
}
参考文献
[1] Pranjal Aggarwal, et al. “AutoMix: Automatically Mixing Language Models.” arXiv:2310.12963, 2024.
[2] Victor Barres, et al. “τ²-Bench: Evaluating Conversational Agents in a Dual-Control Environment.” arXiv:2506.07982, 2025.
[3] José Cambronero, et al. “Abstain and Validate: A Dual-LLM Policy for Reducing Noise in Agentic Program Repair.” arXiv:2510.03217, 2025.
[4] Jinhao Duan, et al. “UProp: Investigating the Uncertainty Propagation of LLMs in Multi-Step Agentic Decision-Making.” arXiv:2506.17419, 2025.
[5] Yichao Fu, et al. “Deep Think with Confidence.” arXiv:2508.15260, 2025.
[6] Zhiyuan Hu, et al. “Uncertainty of Thoughts: Uncertainty-Aware Planning Enhances Information Seeking in Large Language Models.” NeurIPS 2024. arXiv:2402.03271.
[7] Carlos E. Jimenez, et al. “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” ICLR 2024. arXiv:2310.06770.
[8] Saurav Kadavath, et al. “Language Models (Mostly) Know What They Know.” arXiv:2207.05221, 2022.
[9] Jean Kaddour, et al. “Agentic Uncertainty Reveals Agentic Overconfidence.” arXiv:2602.06948, 2026.
[10] Zhewei Kang, et al. “Scalable Best-of-N Selection for Large Language Models via Self-Certainty.” arXiv:2502.18581, 2025.
[11] Alex Kendall, Yarin Gal. “What Uncertainties Do We Need in Bayesian Deep Learning for Computer Vision?” NeurIPS 2017. arXiv:1703.04977.
[12] Adrian Kieback, et al. “TASR: Training-Free Adaptive Stopping for Iterative Retrieval.” arXiv:2606.13814, 2026.
[13] Michael Kirchhof, Gjergji Kasneci, Enkelejda Kasneci. “Position: Uncertainty Quantification Needs Reassessment for Large Language Model Agents.” ICML 2025. arXiv:2505.22655.
[14] Polina Kirichenko, et al. “AbstentionBench: Reasoning LLMs Fail on Unanswerable Questions.” arXiv:2506.09038, 2025.
[15] Lorenz Kuhn, Yarin Gal, Sebastian Farquhar. “Semantic Uncertainty: Linguistic Invariances for Uncertainty Estimation in Natural Language Generation.” ICLR 2023. arXiv:2302.09664.
[16] Divake Kumar, et al. “Uncertainty Quantification for Computer-Use Agents: A Benchmark across Vision-Language Models and GUI Grounding Datasets.” arXiv:2606.25760, 2026.
[17] Ziming Li, et al. “Same Signal, Opposite Meaning: Direction-Informed Adaptive Learning for LLM Agents.” arXiv:2605.06908, 2026.
[18] Stephanie Lin, Jacob Hilton, Owain Evans. “Teaching Models to Express Their Uncertainty in Words.” TMLR 2022. arXiv:2205.14334.
[19] Andrey Malinin, Mark Gales. “Uncertainty Estimation in Autoregressive Structured Prediction.” ICLR 2021. arXiv:2002.07650.
[20] Grégoire Mialon, et al. “GAIA: A Benchmark for General AI Assistants.” ICLR 2024. arXiv:2311.12983.
[21] Changdae Oh, et al. “Uncertainty Quantification in LLM Agents: Foundations, Emerging Challenges, and Opportunities.” arXiv:2602.05073, 2026.
[22] Victor Ojewale, et al. “What Benchmarks Don’t Measure: The Case for Evaluating Abstention Competence in Autonomous Agents.” arXiv:2606.02965, 2026.
[23] Arka Pal, et al. “Knowing What You Know Is Not Enough: Large Language Model Confidences Don’t Align With Their Actions.” arXiv:2511.13240, 2025.
[24] Stephan Rabanser, et al. “Towards a Science of AI Agent Reliability.” arXiv:2602.16666, 2026.
[25] Suresh Raghu, Satwik Pandey, Shashwat Pandey. “Proper Scoring Rules for Agentic Uncertainty Quantification.” arXiv:2605.24756, 2026.
[26] Ashish Rana, et al. “Oblivion: Self-Adaptive Agentic Memory Control through Decay-Driven Activation.” arXiv:2604.00131, 2026.
[27] Allen Z. Ren, et al. “Robots That Ask For Help: Uncertainty Alignment for Large Language Model Planners.” CoRL 2023. arXiv:2307.01928.
[28] Arindam Sharma, Cristina David. “Assessing Correctness in LLM-Based Code Generation via Uncertainty Estimation.” arXiv:2502.11620, 2025.
[29] Kaiwen Shi, et al. “Confidence Laundering in Agent Systems: Why Uncertainty Needs a Latent Carrier.” arXiv:2606.20662, 2026.
[30] Noah Shinn, et al. “Reflexion: Language Agents with Verbal Reinforcement Learning.” NeurIPS 2023. arXiv:2303.11366.
[31] Adi Simhi, et al. “Old Habits Die Hard: How Conversational History Geometrically Traps LLMs.” arXiv:2603.03308, 2026.
[32] Akshit Sinha, et al. “The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs.” arXiv:2509.09677, 2025.
[33] Manan Suri, et al. “Structured Uncertainty guided Clarification for LLM Agents.” arXiv:2511.08798, 2025.
[34] Sina Tayebati, et al. “TRACER: Trajectory Risk Aggregation for Critical Episodes in Agentic Reasoning.” ICML 2026. arXiv:2602.11409.
[35] Katherine Tian, et al. “Just Ask for Calibration: Strategies for Eliciting Calibrated Confidence Scores from Language Models Fine-Tuned with Human Feedback.” EMNLP 2023. arXiv:2305.14975.
[36] Eren Unlu. “Know When to Trust the Skill: Delayed Appraisal and Epistemic Vigilance for Single-Agent LLMs.” arXiv:2604.16753, 2026.
[37] Sanidhya Vijayvargiya, et al. “Ambig-SWE: Interactive Agents to Overcome Underspecificity in Software Engineering.” arXiv:2502.13069, 2025.
[38] Guanzhi Wang, et al. “Voyager: An Open-Ended Embodied Agent with Large Language Models.” arXiv:2305.16291, 2023.
[39] Jiawei Wang, et al. “Are LLM Decisions Faithful to Verbal Confidence?” arXiv:2601.07767, 2026a.
[40] Qingni Wang, et al. “SafeGround: Know When to Trust GUI Grounding Models via Uncertainty Calibration.” arXiv:2602.02419, 2026b.
[41] Xuezhi Wang, et al. “Self-Consistency Improves Chain of Thought Reasoning in Language Models.” ICLR 2023. arXiv:2203.11171.
[42] Wujiang Xu, et al. “A-MEM: Agentic Memory for LLM Agents.” arXiv:2502.12110, 2025.
[43] Weihao Xuan, et al. “The Confidence Dichotomy: Analyzing and Mitigating Miscalibration in Tool-Use Agents.” ACL 2026. arXiv:2601.07264.
[44] Daniel Yang, Yao-Hung Hubert Tsai, Makoto Yamada. “On Verbalized Confidence Scores for LLMs.” arXiv:2412.14737, 2024.
[45] Shunyu Yao, et al. “ReAct: Synergizing Reasoning and Acting in Language Models.” ICLR 2023. arXiv:2210.03629.
[46] Shunyu Yao, et al. “Tree of Thoughts: Deliberate Problem Solving with Large Language Models.” NeurIPS 2023. arXiv:2305.10601.
[47] Luke Yoffe, et al. “DebUnc: Improving Large Language Model Agent Communication With Uncertainty Metrics.” arXiv:2407.06426, 2024.
[48] Skylar Zhai, et al. “Abstain-R1: Calibrated Abstention and Post-Refusal Clarification via Verifiable RL.” arXiv:2604.17073, 2026.
[49] Jiaxin Zhang, Prafulla Kumar Choubey, Kung-Hsiang Huang, Caiming Xiong, Chien-Sheng Wu. “Agentic Uncertainty Quantification.” EMNLP 2026. arXiv:2601.15703.
[50] Jiaxin Zhang, Caiming Xiong, Chien-Sheng Wu. “Agentic Confidence Calibration.” ICML 2026. arXiv:2601.15778.
[51] Jiaxin Zhang, et al. “From Passive Metric to Active Signal: The Evolving Role of Uncertainty Quantification in Large Language Models.” arXiv:2601.15690, 2026c.
[52] Jiaxin Zhang, et al. “The Illusion of Certainty: Decoupling Capability and Calibration in On-Policy Distillation.” arXiv:2604.16830, 2026d.
[53] Andrew Zhao, et al. “ExpeL: LLM Agents Are Experiential Learners.” AAAI 2024. arXiv:2308.10144.
[54] Qiwei Zhao, et al. “SAUP: Situation Awareness Uncertainty Propagation on LLM Agent.” ACL 2025. arXiv:2412.01033.
[55] Reflection. “Introducing Beam: Reflection’s 501B Open-Weight Model.” October 5, 2026.
[56] Violet Xiang, et al. “Just Enough Thinking: Efficient Reasoning with Adaptive Length Penalties Reinforcement Learning.” arXiv:2506.05256, 2025.